AI – vad är det och hur fungerar det?
I detta avsnitt finns information om vad artificiell intelligens (AI) är mer generellt.
Avsnittet innehåller:
- Vad är AI?
- Maskininlärning
- Olika sorters AI
- Data
- Generativ AI
- Partiskhet (bias), felaktigheter och hallucinationer
- Sammanfattning
Partiskhet, felaktigheter och hallucinationer
Partiskhet (Bias)
Partiskhet eller bias, är ett viktig och centralt begrepp att förstå när man arbetar med generativ AI. Eftersom generativa modeller tränas på stora mängder text, bilder eller annat innehåll som hämtats från verkliga källor, kommer de att spegla de mönster som finns i denna data, även de oönskade. Om träningsdatan innehåller fördomar, stereotyper eller en sned representation av olika grupper, riskerar modellen att återge och till och med förstärka dessa i sitt genererade innehåll. Ett exempel kan vara en bildgenererande modell som konsekvent framställer vissa yrken med ett visst kön, eller en textmodell som uttrycker sig nedlåtande om en viss grupp, helt enkelt därför att sådana mönster var vanliga i träningsdatan.
Exempel - Skapa bild i Google Gemini: |
|
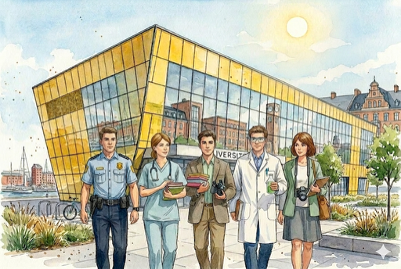
Prompten till bilden löd: Gör en akvarellmålningen i proportionerna 3:2. Bilden ska representera olika yrkesgrupper som tex polis, sjuksköterska, lärare, biolog, kemist, journalist som är på väg ut ur en universitetsbyggnad. Gör byggnaden i en modern i stil i likhet med den på det uppladdade fotot (foto på hus Stella uppladdat).
Om man inte specificerar vilket kön personerna som representerar olika yrkesgrupper ska ha blir det så gott som alltid en traditionell representation, det vill säga med en manlig polis och en kvinnlig sjuksköterska. |
Det är viktigt att betona att partiskhet sällan är något som programmerats in medvetet, utan ofta uppstår som en oavsiktlig följd av datans sammansättning och de val som görs under utvecklingen. Kvaliteten i träningsdatan påverkar därför direkt kvaliteten och rättvisan i modellens resultat. Att hantera partiskhet kräver ett aktivt arbete, exempelvis genom att granska och bearbeta datan, utvärdera modellens utdata kritiskt och tillämpa metoder som motverkar snedvridning. I vissa modeller och tjänster bygger man in så kallade guardrails vilket är ett samlingsnamn för de tekniska och organisatoriska skyddsmekanismer som ser till att en modell följer önskade regler och värderingar. De kan bestå av regler inbyggda i modellen, till exempel att den alltid ska vägra ge instruktioner som kan orsaka skada, oavsett hur användaren formulerar sin fråga.
För den som använder generativ AI är medvetenhet om dessa anpassningar och begränsningar en förutsättning för ett ansvarsfullt och kritiskt förhållningssätt.
Felaktigheter och hallucinationer
Man säger ibland att stora språkmodeller hallucinerar när deras svar inte stämmer överens med verkligheten, alltså när de genererar felaktig information. I själva verket gör modellen dock ingen skillnad mellan att generera sant och osant innehåll. Ur modellens perspektiv är processen densamma i båda fallen. Modellen skapar helt enkelt text utifrån statistiska mönster för hur ord och formuleringar brukar följa på varandra, inte utifrån någon förståelse av vad som faktiskt är sant. Därför krävs det mänsklig granskning och källkritisk medvetenhet när generativ AI används i praktiken.
|
|
|
Så kan felaktig information spridas via AI-modeller
Podden nedan diskuterar resultatet av ett experiment som gjordes av forskare på Göteborgs universitet. Exemplet illustrerar hur felaktig information tar sig in i AI-modeller och vad det kan få för konsekvenser. Du kan läsa om det som diskuteras i podden i artikeln Scientists invented a fake disease. AI told people it was real samt på Wikipedia - Bixomania
Podden är gjord med verktyget Google Notebook LM.